在近日举行的 Intel Connection 大会上,英特尔用一套完整的技术演进体系向业界揭示了一个正在发生的范式转移:当芯片热设计功率向5000W乃至更高迈进时,散热技术的天花板已不再是如何把热量带走,而是如何在芯片表面把散热做到极限。这场以Cooling Begins at the Chip(散热始于芯片)为宣言的变革,正在把增材制造(AM)推上液冷产业的核心舞台。
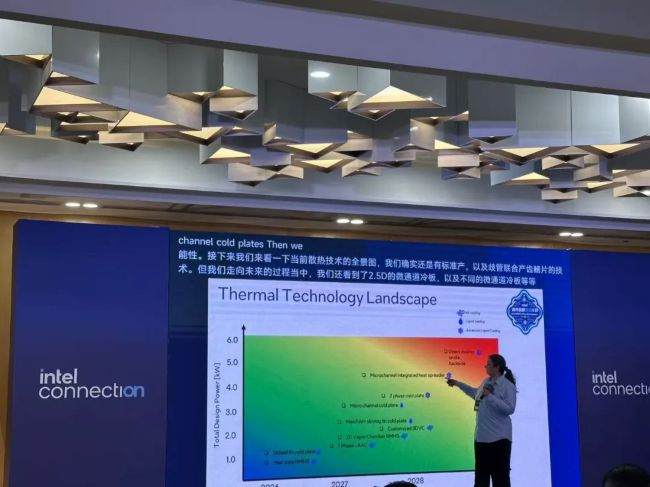 ▲散热技术发展路线图
© 3D科学谷
 ▲ 液冷冷板的关键设计驱动因素
© 3D科学谷白皮书
 英特尔的判断
风冷撞墙,液冷进入芯片级深水区
英特尔在大会现场首先给出了一组不容回避的物理事实:风冷的扩展正呈现收益递减、成本飙升的剪刀差曲线——更大的散热器与更高的风扇转速只能换来边际递减的结温改善,而风扇功耗、声学问题与可靠性风险却急剧上升。从2U增强风冷(EVAC)、热管远程散热器(Remote HS),到标准冷板与最高密度的3D均热板(6U 3D VC),风冷与常规液冷的产品演进已逼近终点。
随之而来的是一场液冷部署模式的切换。英特尔将当前客户部署归纳为两条路径:新建AI及托管机房普遍采用冷机一体化液冷数据中心方案,冷机从设计之初即融入设施核心,第一天即支持更高机柜功率密度;而存量风冷机房则通过液冷侧车(sidecar)方案渐进改造,以换热器方式接入液冷,作为向高密度过渡的桥梁。
真正值得注意的是技术底座的深层变化。英特尔系统梳理了2017–2026年多代、经超大规模客户验证的液冷技术谱系——单相直触冷板(Single-Phase DTC,已在超大规模数据中心以PG25基液验证)、两相直触冷板(2-Phase DTC,以更低流量应对极端热流密度)与浸没式冷却——并明确指出:面向下一代AI机架,液冷的竞争焦点已上移至芯片界面本身。
范式革命的核心:
消除界面、逼近硅片
英特尔在本次大会上释放的最强信号,是 MC-IHS(Micro-Channel Integrated Heat Spreader,微通道集成热扩散器)与先进冷板架构的集中亮相。
MC-IHS 实现22%–30%的热性能提升:传统散热栈为冷板—TIM2—热扩散器(IHS)—TIM1—芯片裸片,多层界面层层叠加热阻;MC-IHS 将冷板功能直接集成进处理器热扩散器,彻底消除冷板与IHS之间的完整界面层——这正是传统设计中热阻的主要来源。验证数据显示,MC-IHS 相比参考方案带来22%–30%的热性能改善,目标热阻剑指行业领先规格。
三种先进冷板架构并行推进:英特尔同时展示了2.5D微通道冷板(面向未来超高功率AI平台,在硅片界面实现精准冷却剂输送与最佳热点抑制)、3D多层冷板(堆叠微流控层最大化换热面积,多注入歧管优化流量分配,三者中热流密度承载能力最高)、以及铲齿鳍片+分流式歧管冷板(在热性能与可制造性间取得平衡,针对量产优化)。三者均经过CFD热-流联合仿真验证。
功率阶梯决定了制造工艺的代际跨越: 在英特尔绘制的散热技术全景图上,技术坐标按总设计功率清晰分层:1–2kW区间由铲齿鳍片冷板、热管散热器、单相LAAC占据;2–4kW区间由歧管+铲齿鳍片冷板、定制3D VC、微通道冷板接棒;4–6kW及以上区间,则属于两相冷板、MC-IHS,直至裸片背面直冷(Direct Cooling on Die Backside)。英特尔同时坦承:即便在液冷内部,微射流冲击等方案的设计复杂度与可靠性挑战也在同步上升——越靠近芯片,流道越微细、几何越复杂、制造越困难。在这方面,英特尔正在测试3D打印的冷板性能。
根据3D科学谷的市场洞察,这正是增材制造的历史性机遇:传统加工无法实现曲面、分叉与异形流道,多层堆叠结构需多部件拼接、焊缝即泄漏隐患;而金属3D打印可将冷板一体化成型,实现更高的内部流道精度,更微细的翅片,以及采用TPMS等三维拓扑结构可将有效散热面积扩大数倍。
SynaCore AM-DT:
为芯片级散热补上确定性制造底座
但机遇的另一面是硬约束。MC-IHS 与多层微通道冷板的流道特征尺寸已进入百微米量级,此类复杂零件对增材制造提出了两个前所未有的挑战:其一,多尺度物理耦合——粉末尺度(20–60μm)的熔池行为、介观尺度的微观组织演化、零件尺度的热历史与残余应力变形,共同决定流道的最终成形质量,任何单一尺度的经验模型都不足以预测;其二,表面粗糙度——增材制造内流道的表面粗糙度直接影响流阻、压降与换热系数,而内流道粗糙度在打印前无法测量、打印后难以加工修正,只能依赖预测与控制。
针对这两大挑战,源自新加坡的 SynaCore AM-DT 物理AI增强增材制造数字孪生软件,提供了针对性解法:
多尺度仿真:从熔池到零件的贯通预测。 SynaCore AM-DT 数字孪生的多模态物理仿真模型与AI算法覆盖粉末—熔池—微观组织—零件性能的全链路:从打印态微观组织(含析出相)预测机械性能,并进一步预测热处理结果;对冷板而言,这意味着可预判微通道的成形质量、残余应力分布与变形趋势,提前识别气密性失效风险。尤为关键的是,这一能力建立在基于SynaCore第一性原理物理规律的全尺度仿真之上,这与冷板的几何个体化强、流-热-力耦合复杂的特点高度契合,避免了降阶模型在全新构型上外推失准的风险。
表面粗糙度预测:把流道内壁状态变成设计变量。 在微通道尺度下,表面粗糙度与流道直径的比值显著放大,粗糙峰不仅抬高压降、诱发流动分离,还会成为空化与污垢沉积的起点。SynaCore AM-DT 对打印表面形貌的预测能力,使工程师能够在设计阶段就将粗糙度作为约束条件——在热性能、压降与可制造性之间做量化权衡,而非事后返工。结合其 Adaptive Tool Path 自适应路径技术对逐层热历史的动态调控,粗糙度有望从随机缺陷转变为可控工艺输出。
跨设备工艺迁移:从单件验证走向批量一致。 SynaCore AM-DT 旨在解决在不同系统与材料上开发工艺参数的行业核心难题,使不同OEM设备进化出各自独特的工艺大脑,破除加工黑箱——这是液冷增材制造从实验室样件走向数据中心批量交付的前提。
预测原理:
粗糙度从多物理场仿真中而生
SynaCore AM-DT 的表面粗糙度预测并非基于统计回归或经验查表,而是嵌在其粉末尺度(powder-scale)多物理场仿真链中的一个自然涌现的物理输出。其技术路径可拆解为四层:
1. 真实粉床构建(输入层)平台首先通过铺粉仿真模块(Powder-Bed Module)模拟刮刀/重涂器运动下的粉末流动,计算粉末堆积密度。关键在于:它使用非球形颗粒模型,并输入实测的粒度分布,这是粗糙度预测可信度的第一道关口——粉床的几何无序性是表面粗糙的重要来源之一。
2. 激光-物质相互作用(能量层)光线追踪模块(Ray Tracing Module)显式模拟激光束在粉床与熔池表面的反射和吸收,精确计算能量吸收率,并评估粉末形貌与粒度分布对能量吸收的影响。这一步决定了熔池的热输入边界条件,而热输入直接决定熔化深度与表面张力驱动的熔池流动(Marangoni 对流),进而影响凝固后的表面形貌。
3. 熔池-凝固-微观组织耦合求解(核心层)粉末尺度模块采用四个求解器耦合的相场(Phase Field)框架:多相热求解器 → 流体动力学求解器 → 相变求解器 → 微观组织求解器,在多个扫描矢量、多层堆叠的条件下,同步显式输出局部温度曲线、熔池形貌、孔隙形成与微观组织演化——表面粗糙度(Surface roughness)即作为该模块的标准输出之一。

4. 界面厚度参数校准(模型校准层)相场模型中界面厚度(interface thickness)是关键自由参数,直接影响模拟表面的粗糙度。AM-DT的机制解释了增材制造表面粗糙的方向性差异:竖直壁面(侧表面)由层层堆积的熔池边缘轮廓主导与水平顶面由最后一层熔池凝固形貌主导的粗糙度的差异。对液冷微通道而言,这一区分至关重要——通道侧壁与顶面的粗糙度对压降和换热的影响权重不同。
液冷散热的确定性爆发已是行业共识,但真正决定产业格局的,是谁能在规模化制造中率先解决质量一致性与成本可控性的难题。Intel在大会上展示的技术路线图清晰地指出了方向——从风冷到液冷、从标准冷板到微通道冷板、从外部散热到芯片级集成。而增材制造,尤其是当它与数字孪生技术深度融合时,正在成为这一路线图从愿景走向量产的关键使能者。
知之既深,行之则远。基于全球范围内精湛的制造业专家智囊网络,3D科学谷为业界提供全球视角的增材与智能制造深度观察。有关增材制造领域的更多分析,请关注3D科学谷发布的白皮书系列。
网站投稿 l 发送至2509957133@qq.com
欢迎转载 l 转载请注明来源3D科学谷 l 链接到3D科学谷网站原文